

Optimizando el Backfill en la Industria 4.0
En el actual paradigma de la Transformación Digital Industrial, la madurez de una infraestructura no se mide por su capacidad de ingesta en condiciones nominales, sino por su resiliencia ante la asincronía.
Uno de los vectores de ineficiencia más críticos en las organizaciones modernas es el Backfill: Siendo el proceso de integrar flujos de datos históricos que llegan tarde o fuera de secuencia. Lo que a menudo se cataloga como un simple incidente técnico es, en realidad, un síntoma de arquitecturas legacy que no fueron diseñadas para la volatilidad y la descentralización del dato actual.
La Naturaleza Crítica del Backfill en Entornos Distribuidos
El backfill representa el desafío de reconciliar la línea temporal de los activos físicos con la realidad técnica de las redes de comunicación. En un ecosistema industrial ideal, los datos fluyen de manera lineal; sin embargo, la realidad operativa impone escenarios complejos:
- Sistemas de Almacenamiento y Reenvío: Los gateways en el Edge almacenan información durante interrupciones de conectividad, volcándola masivamente al restaurarse el servicio.
- Protocolos Asíncronos: El auge del IoT y redes como 5G o satélite introducen latencias que alteran el orden de llegada de los paquetes.
- Integración de Datos Históricos: La consolidación de silos procedentes de migraciones, sistemas de intercambio de archivos o registros manuales que deben coexistir con el flujo en tiempo real.
Para las organizaciones que aspiran a una toma de decisiones basada en la evidencia, el backfill es el factor determinante de la integridad de la información. Sin una gestión nativa del dato fuera de orden, los modelos de analítica avanzada y los indicadores de rendimiento (KPIs) pierden su validez estructural.
El Techo Tecnológico de las Arquitecturas de Archivos (Legacy)
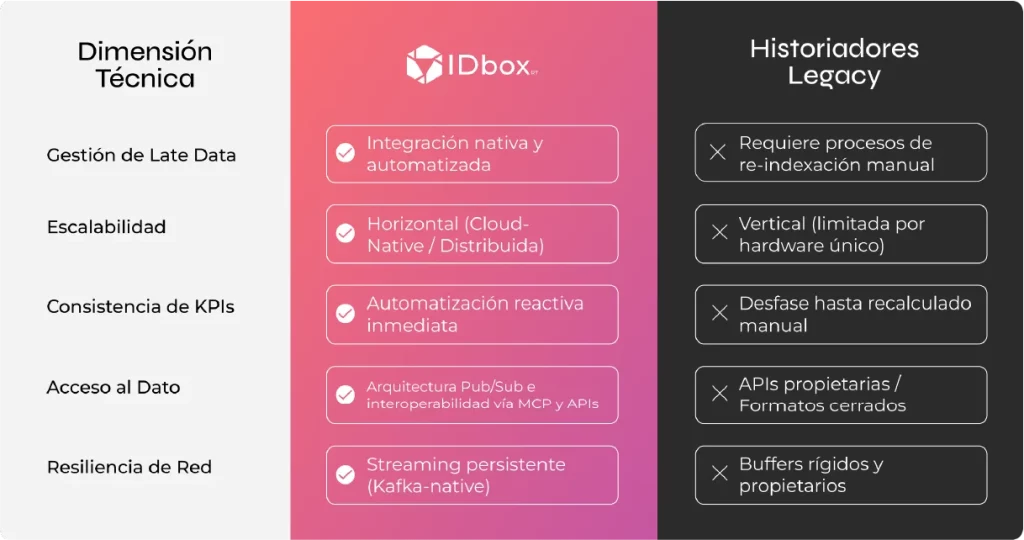
La mayoría de los sistemas de historización tradicionales, diseñados bajo premisas de hace tres décadas, operan mediante un modelo de escritura secuencial en archivos binarios cerrados. Esta arquitectura presenta limitaciones que hoy suponen un riesgo para la escalabilidad:
Fricción por Re-indexación
En sistemas basados en archivos, la inserción de datos históricos requiere reabrir estructuras ya selladas. Este proceso demanda ciclos de CPU masivos para descomprimir, insertar y volver a indexar la información. El resultado es un incremento de la latencia que impacta directamente en la visualización y monitorización de las operaciones actuales.
Degradación de la Eficiencia de Compresión
Los algoritmos de compresión temporal (como el swinging door) están optimizados para datos ordenados. Al enfrentarse a flujos de backfill, estos sistemas a menudo fallan al recalcular las excepciones, lo que resulta en bases de datos sobredimensionadas y una pérdida de fidelidad en la reconstrucción del historial.
Dependencia de Formatos Propietarios
El almacenamiento en «cajas negras» binarias dificulta la interoperabilidad. Recuperar datos históricos para herramientas de Business Intelligence (BI) o Inteligencia Artificial requiere, en estos sistemas, de APIs intermedias que actúan como cuellos de botella técnicos y financieros.
IDboxRT: Un Cambio de Paradigma hacia el Streaming Industrial
IDboxRT propone una evolución arquitectónica fundamental: transitar de la persistencia estática hacia un modelo de Streaming Nativo y Desacoplado. Esta aproximación permite que la infraestructura sea agnóstica al momento en que el dato es recibido, garantizando la continuidad del negocio y la precisión del análisis.
A. Procesamiento de eventos con garantía de no duplicidad (Apache Kafka). A través de un bus de eventos basado en Apache Kafka, IDboxRT separa la adquisición de la persistencia.
- Resiliencia Operativa: El sistema actúa como un buffer dinámico capaz de absorber ráfagas masivas de datos históricos sin penalizar el rendimiento del motor principal.
- Garantía de Unicidad (Idempotencia): Nuestra arquitectura asegura que la re-ingesta de datos (frecuente en procesos de backfill) no genere redundancias, manteniendo una «fuente única de verdad» sin intervención manual.
B. Gestión de Datos de Alta Densidad con Indexación Dinámica
Optimizamos el flujo de datos mediante motores especializados en series temporales. Gracias a la segmentación automática, el sistema garantiza una velocidad de escritura constante independientemente del volumen acumulado, permitiendo el backfill masivo sin penalizar la operativa actual.
El Valor Añadido: Agregaciones Reactivas y «Data Integrity»
El verdadero potencial se manifiesta en la capacidad de procesamiento posterior a la ingesta. Mientras que los sistemas legacy requieren procesos manuales para corregir los KPIs tras un backfill, IDboxRT implementa un motor de cálculo reactivo.
Cuando el sistema detecta una inserción con marca de tiempo pasada, desencadena automáticamente el recalculado de las variables con las que existe algún tipo de dependencia. Esto garantiza que el Unified Name Space (UNS) de la compañía se actualice dinámicamente, asegurando que los cuadros de mando reflejen siempre la realidad histórica completa.
Casos de Uso: Resiliencia en Sectores Críticos
- Energías Renovables: En parques eólicos o fotovoltaicos con conexiones satelitales, el backfill es una operación diaria. IDboxRT permite recuperar días de inactividad en minutos, asegurando que los balances energéticos sean precisos para la liquidación.
- Logística y Cadena de Frío: Sensores en tránsito que descargan sus históricos por lotes. Nuestra arquitectura integra estos datos de forma fluida, permitiendo auditorías de calidad sin brechas temporales.
- Smart Cities: Gestión de grandes redes de sensores con diferentes frecuencias de muestreo y retardos de red, donde la convergencia del dato es crítica para la gestión de servicios públicos.
Soberanía del Dato: SQL Estándar vs. Ecosistemas Cerrados
Uno de los pilares de nuestra propuesta es la Soberanía del Dato. Al utilizar estándares abiertos y acceso nativo vía SQL, IDboxRT elimina dependencia cautiva del proveedor. Los datos recuperados mediante backfill están disponibles de inmediato para su explotación en PowerBI, Grafana o modelos avanzados de Machine Learning, sin necesidad de conectores propietarios costosos.
De Datos a Decisiones: El Impacto en el Negocio
Este debate no es meramente académico o informático. Tiene un impacto directo en la toma de decisiones. Si tu sistema no es capaz de integrar correctamente los datos que llegan fuera de orden tiene afectación directa en tu negocio:
- Perderás la capacidad de modificar tus datos y emplearás tiempo y esfuerzo en realizar recálculos además de validaciones.
- Tus informes de OEE serán inconsistentes hasta que se complete un proceso manual de corrección.
- Tus modelos de Machine Learning se entrenarán con huecos temporales, reduciendo su precisión.
- Tu balance energético no cuadrará, dificultando el cumplimiento de normativas de sostenibilidad.
El salto real en la transformación digital no consiste en acumular más datos, sino en construir una infraestructura que no dependa de que el mundo sea perfecto. El orden no debe ser un requisito previo, sino una garantía del sistema.
¿Preparado para evolucionar su estrategia de datos?
Si el backfill sigue siendo una tarea manual tediosa o si su sistema actual de historización se ha convertido en un cuello de botella para su crecimiento, es momento de mirar hacia arquitecturas flexibles y abiertas.
Contacta con nuestro equipo de expertos para descubrir cómo IDboxRT puede ayudarle a centralizar, historizar y explotar sus datos industriales sin importar cuándo o cómo lleguen.
Deja una respuesta